
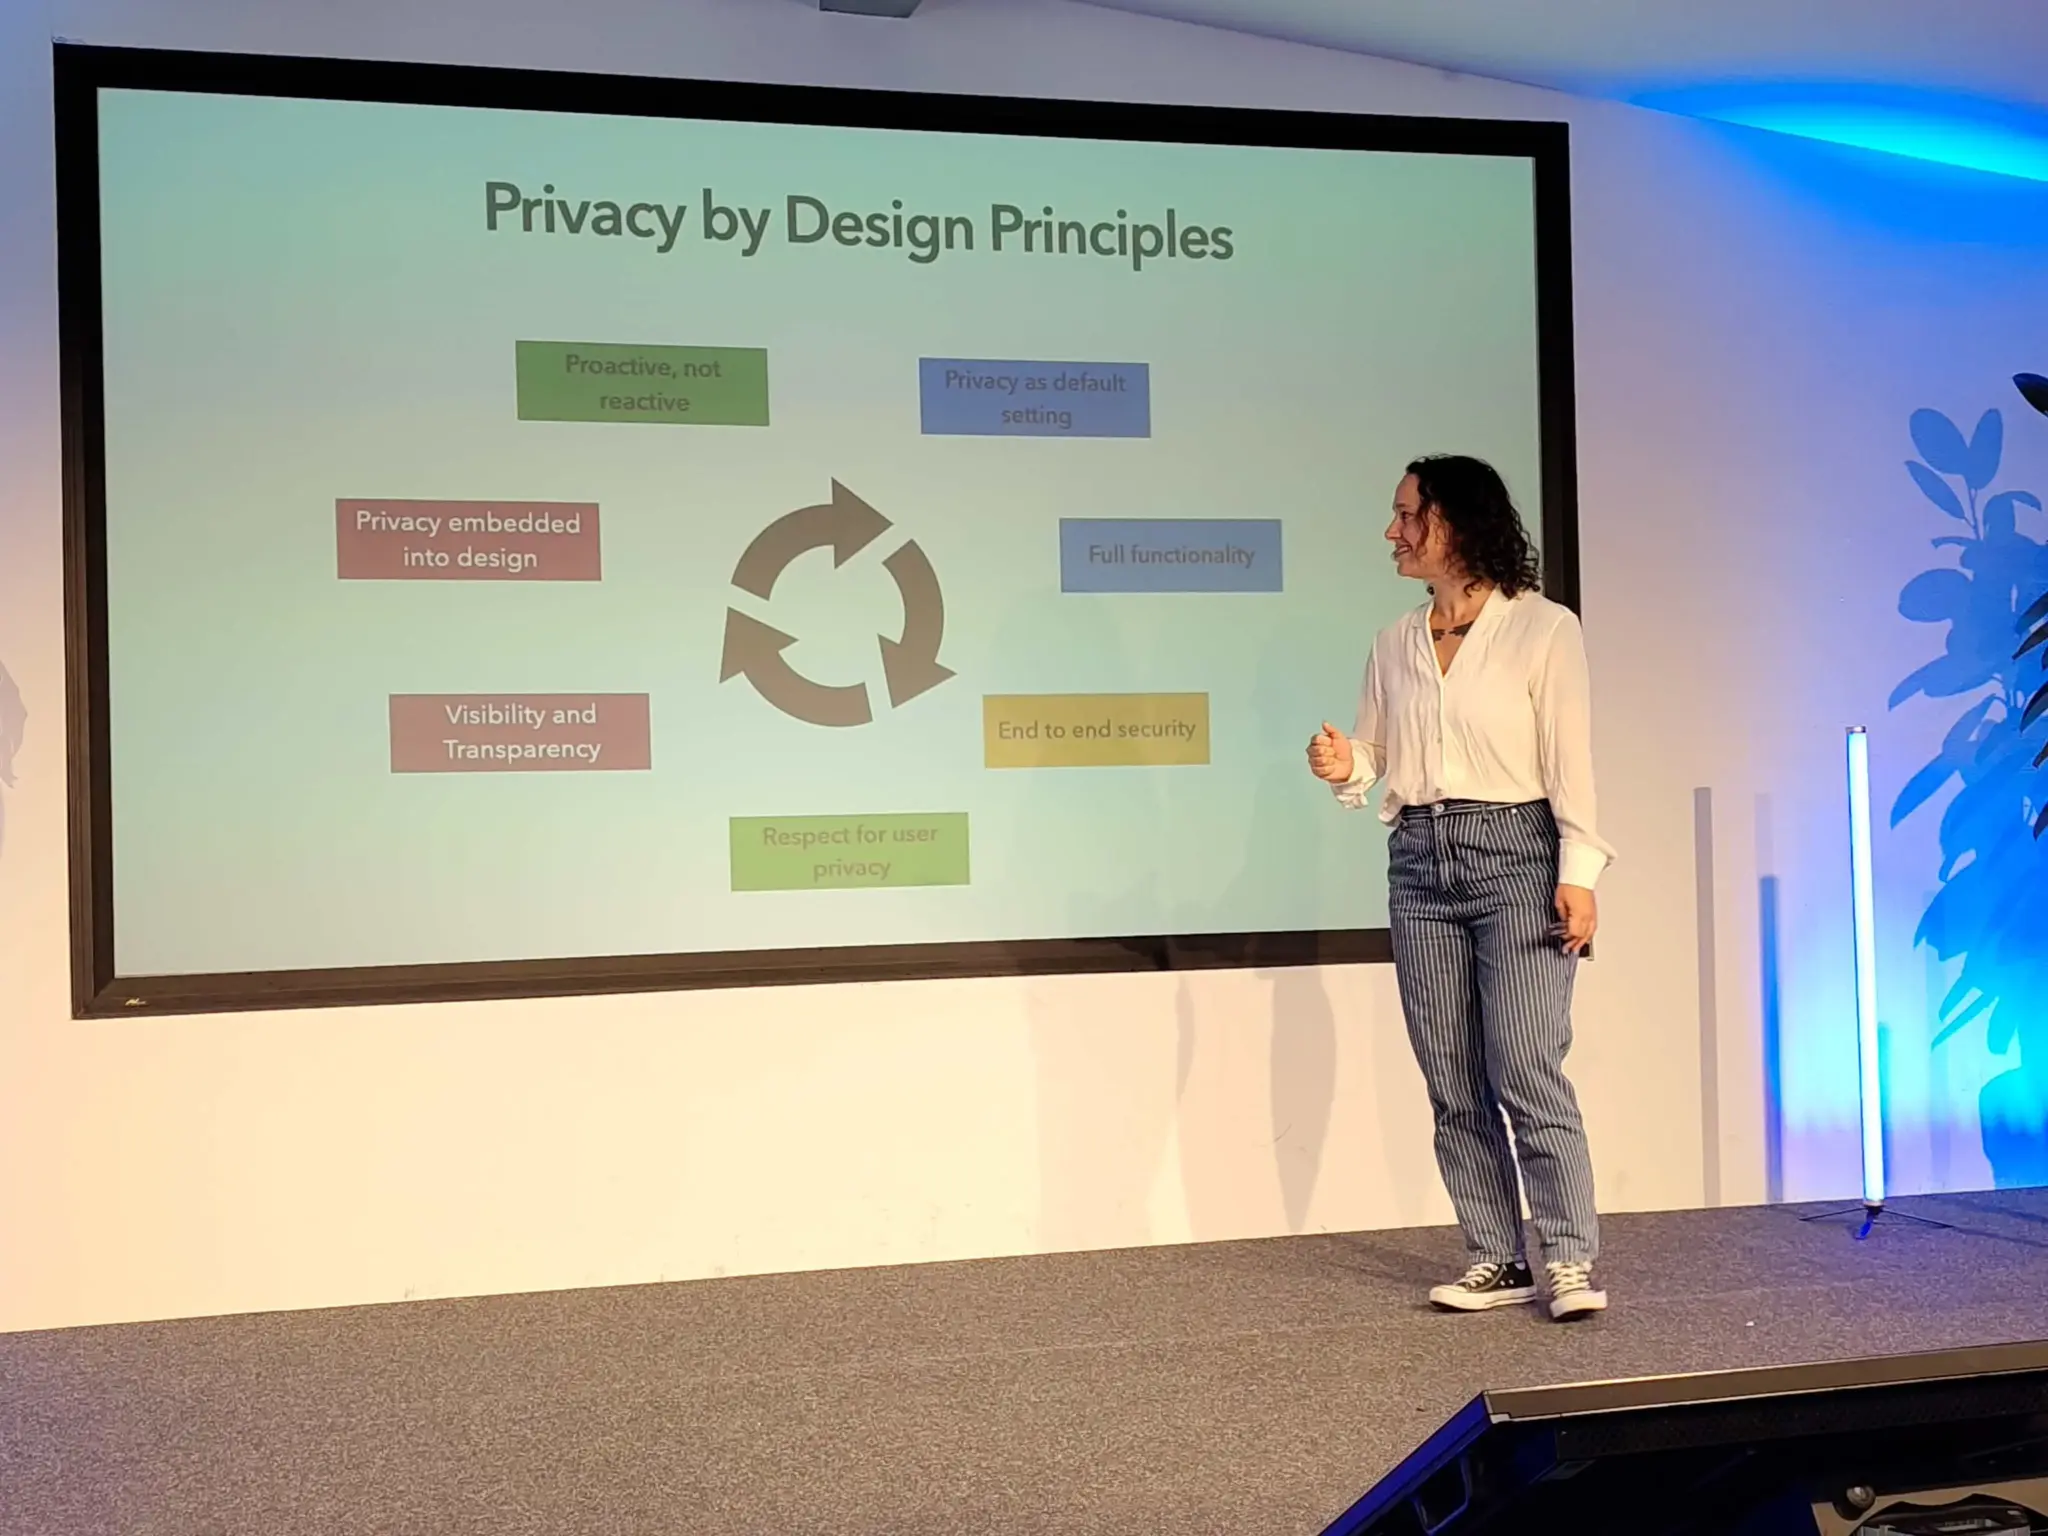
Privacy wordt bij de ontwikkeling van software nog te vaak behandeld als iets dat later wel kan worden geregeld. Eerst wordt een applicatie gebouwd, worden databronnen gekoppeld en worden eventueel AI-modellen toegevoegd. Daarna kijkt iemand welke privacymaatregelen nog nodig zijn. Volgens Katharine Jarmul is dat precies de verkeerde volgorde. Privacy moet vanaf het eerste ontwerp onderdeel zijn van de technische keuzes die developers maken. Ze gaf hierover een presentatie tijdens de Nextcloud Community Conferentie die afgelopen dagen in Berlijn werd georganiseerd.
Jarmul is gespecialiseerd in privacy en security binnen machine learning, AI en data science. Ze schreef ook het boek Practical Data Privacy, waarin ze laat zien hoe privacytechnieken daadwerkelijk kunnen worden toegepast in data- en AI-systemen. In haar presentatie draaide het vooral om een eenvoudig uitgangspunt: privacy is niet alleen een kwestie voor juristen, compliance-afdelingen of securityspecialisten. Ook developers bepalen met hun architectuur en code hoeveel privacy gebruikers uiteindelijk hebben. Dat idee staat bekend als privacy by design.
Privacy als onderdeel van het ontwerp
Privacy by design betekent dat bescherming van persoonsgegevens vanaf het begin wordt meegenomen bij het ontwerpen van een systeem. Dus niet eerst alle mogelijke data verzamelen en later proberen die gegevens af te schermen, maar al tijdens het ontwerp vragen stellen als: hebben we deze informatie eigenlijk nodig? Waar wordt zij opgeslagen? Hoe lang bewaren we haar? Wie kan erbij? En wat gebeurt er wanneer een gebruiker zijn toestemming intrekt?
Het concept gaat terug op het werk van de Canadese privacy-expert Ann Cavoukian. Een belangrijk uitgangspunt daarbij is dat privacy de standaardinstelling moet zijn. Een gebruiker zou niet eerst een lange lijst instellingen hoeven doorlopen om zichzelf enigszins te beschermen. Een systeem moet standaard zo weinig mogelijk persoonlijke informatie verzamelen en delen.
Dat klinkt logisch, maar is voor developers niet altijd eenvoudig. Jarmul wees in haar presentatie op een interessant verschil. Privacyprincipes zijn vaak breed geformuleerd en daardoor open voor interpretatie. Engineers zijn juist gewend te werken met duidelijke specificaties, beperkingen en ontwerpen. Een opdracht als “respecteer de privacy van de gebruiker” is moeilijk rechtstreeks om te zetten in code. De uitdaging is daarom om algemene privacyprincipes te vertalen naar concrete technische beslissingen.
Begin met de vraag welke data echt nodig is
Een van de belangrijkste maatregelen die developers kunnen nemen, is verrassend eenvoudig: minder data gebruiken. Bij nieuwe toepassingen ontstaat gemakkelijk de neiging om zoveel mogelijk informatie te verzamelen. Data die vandaag niet nodig is, zou morgen misschien van pas kunnen komen. Zeker rond machine learning en AI is jarenlang het idee ontstaan dat meer trainingsdata vrijwel automatisch beter is.
Vanuit privacyoogpunt ontstaat daarmee echter ook een groter risico. Data die nooit is verzameld, kan immers ook niet uitlekken, worden misbruikt of voor een onverwacht ander doel worden ingezet. Privacy by design betekent daarom dat developers al tijdens het ontwerp bekijken welke informatie werkelijk noodzakelijk is voor een bepaalde functie. Kun je een aanbeveling maken zonder een volledig gebruikersprofiel op een centrale server op te bouwen? Moet een exacte locatie worden opgeslagen of is een minder nauwkeurig gebied voldoende? Moeten gegevens jarenlang worden bewaard als ze na enkele dagen geen functie meer hebben? Dit wordt vaak aangeduid als dataminimalisatie, aldus Jarmul.
Breng privacyrisico’s net zo in kaart als securityrisico’s
Ze liet ook zien dat developers privacy veel systematischer kunnen behandelen. Een voorbeeld hiervan is LINDDUN, een methode voor privacy threat modeling. Het idee lijkt op threat modeling uit cybersecurity. Developers brengen vooraf in kaart hoe een systeem kan worden aangevallen of misbruikt en bouwen daartegen maatregelen in. Alleen kijkt LINDDUN specifiek naar bedreigingen voor privacy, zoals het kunnen koppelen van gegevens aan één persoon, het verzamelen van meer informatie dan noodzakelijk of het ongewenst openbaar maken van gegevens.
Daarmee wordt privacy ineens een stuk concreter. Een ontwikkelteam hoeft niet alleen de abstracte vraag te beantwoorden of een systeem “voldoende privacyvriendelijk” is. Het team kan per component onderzoeken welke gegevens binnenkomen, waar ze naartoe gaan en welke privacyrisico’s daarbij ontstaan.
Dat is vooral relevant bij AI. Machine-learningmodellen verwerken soms enorme hoeveelheden gegevens en kunnen in sommige gevallen zelfs informatie over hun trainingsdata prijsgeven. Het beschermen van de oorspronkelijke database is dan niet per definitie voldoende. Ook het model en de manier waarop gebruikers daarmee kunnen communiceren moeten onderdeel zijn van de risicoanalyse.
Wie zit er eigenlijk aan tafel?
Privacy by design is volgens Jarmul bovendien niet uitsluitend een technisch probleem. Een van haar slides stelde een simpele maar belangrijke vraag: wie zit er bij een teamvergadering in de kamer en wie kan zich uitspreken? Bij het ontwerpen van een toepassing kunnen developers, data scientists, productmanagers, securityspecialisten en privacydeskundigen allemaal vanuit een ander perspectief naar dezelfde functie kijken. Een productmanager wil bijvoorbeeld zoveel mogelijk informatie om een dienst persoonlijker te maken. Een data scientist ziet interessante mogelijkheden om nieuwe modellen te trainen. Een privacydeskundige kan ondertussen wijzen op de risico’s die daardoor ontstaan.
Juist die discussie moet vroeg plaatsvinden. Niet wanneer de applicatie al bijna klaar is, maar op het moment dat nog kan worden besloten hoe gegevens worden verzameld en verwerkt.
Local-first als technische keuze
Een ander onderwerp dat Jarmul aansnijdt is de local-first-beweging. Daarbij worden gegevens waar mogelijk op het apparaat van de gebruiker verwerkt en opgeslagen, in plaats van standaard naar een centrale cloudomgeving te worden gestuurd. Dat kan een krachtige privacymaatregel zijn, vertelde ze.
Neem een applicatie die aanbevelingen doet. Technisch is het mogelijk om alle gebruikersgegevens naar een server te sturen en daar een profiel samen te stellen. Maar wellicht kan een deel van die analyse ook lokaal op een laptop of smartphone plaatsvinden. Persoonlijke gegevens hoeven dan helemaal niet naar de aanbieder te worden gestuurd. Dat betekent niet dat iedere toepassing volledig lokaal moet werken. Het betekent vooral dat developers die mogelijkheid bewust meenemen in hun ontwerp.
Hetzelfde geldt voor instellingen. Jarmul laat een voorbeeld zien waarbij gebruikers expliciet kunnen aangeven of gegevens mogen worden gedeeld, uitsluitend lokaal mogen worden opgeslagen of helemaal niet mogen worden gebruikt. Wanneer een nieuwe functie wordt toegevoegd, krijgt de gebruiker opnieuw de mogelijkheid om daarover te beslissen. Privacy wordt daarmee onderdeel van de gebruikerservaring.
Bouw de rechten van gebruikers in de software
Ook privacyrechten moeten technisch uitvoerbaar zijn. Onder de Europese AVG hebben gebruikers onder meer het recht om hun persoonsgegevens in te zien, gegevens te laten corrigeren of verwijderen, bezwaar te maken tegen verwerking en onder bepaalde omstandigheden hun gegevens mee te nemen naar een andere aanbieder.
Dat klinkt in eerste instantie als een juridisch onderwerp. Maar uiteindelijk moet software deze rechten mogelijk maken. Kan een organisatie bijvoorbeeld precies terugvinden welke informatie over één persoon verspreid over verschillende databases staat? Kunnen die gegevens vervolgens daadwerkelijk worden verwijderd? Wat gebeurt er met back-ups? En hoe werkt dat wanneer gegevens inmiddels zijn gebruikt voor analytics of machine learning?
Wanneer daar pas over wordt nagedacht nadat een gebruiker een verwijderverzoek heeft ingediend, kan het technisch bijzonder ingewikkeld worden. Privacy by design betekent daarom dat zulke mogelijkheden al in de architectuur worden meegenomen.
Privacy gaat uiteindelijk over mensen
Daarmee komt Jarmul uiteindelijk bij een bredere boodschap. Op een van haar laatste slides vatte ze die samen als: “Respecting privacy is putting humans first.” Dat betekent volgens haar niet alleen nadenken over onbekende eindgebruikers. Het gaat net zo goed over onszelf, vrienden, familie en collega’s. Developers maken voortdurend keuzes over technologie, software, modellen en datasets. Die keuzes bepalen mede welke wereld met die technologie wordt gebouwd.
Daarbij horen ook nieuwe privacytechnieken. In Practical Data Privacy behandelt Jarmul bijvoorbeeld technieken als differential privacy, federated learning en encrypted computation. Zulke methoden kunnen het mogelijk maken om analyses of machine learning uit te voeren zonder alle onderliggende persoonlijke gegevens centraal en onbeveiligd samen te brengen.
Maar privacy by design begint niet bij ingewikkelde cryptografie. Het begint veel eerder, bij simpele vragen in een ontwikkelteam. Hebben we deze gegevens echt nodig? Kunnen we het met minder doen? Kan verwerking lokaal plaatsvinden? Wie krijgt toegang? Kunnen gebruikers daadwerkelijk bepalen wat er met hun informatie gebeurt? En kunnen we gegevens ook weer verwijderen?
Juist developers hebben daardoor veel meer invloed op privacy dan misschien wordt gedacht. Iedere database, API, standaardinstelling en AI-pipeline bevat uiteindelijk keuzes over gegevens. Wie privacy pas na het programmeren toevoegt, moet achteraf proberen die keuzes te repareren. Wie privacy by design toepast, maakt ze vanaf het begin bewust.


0 Reacties